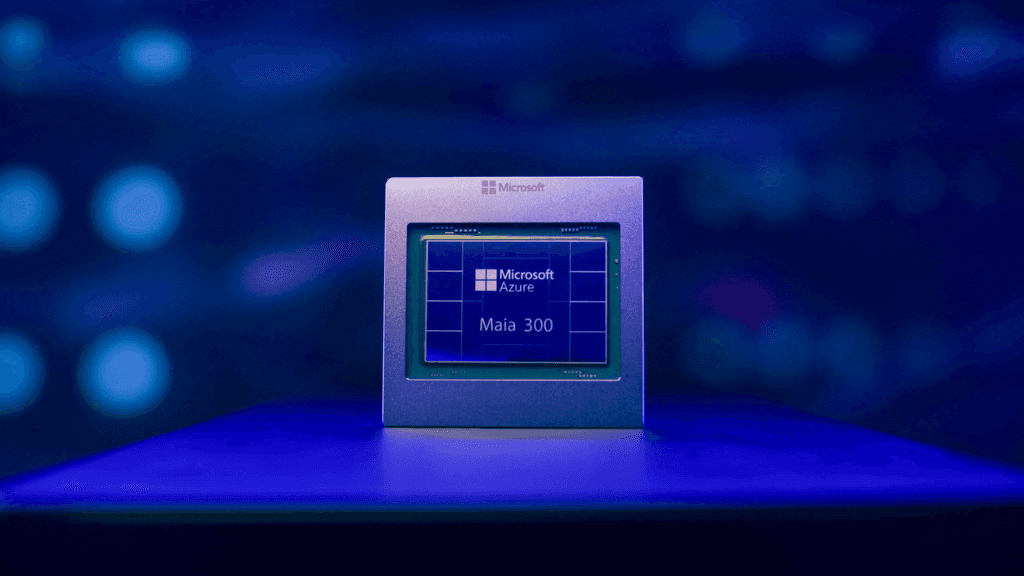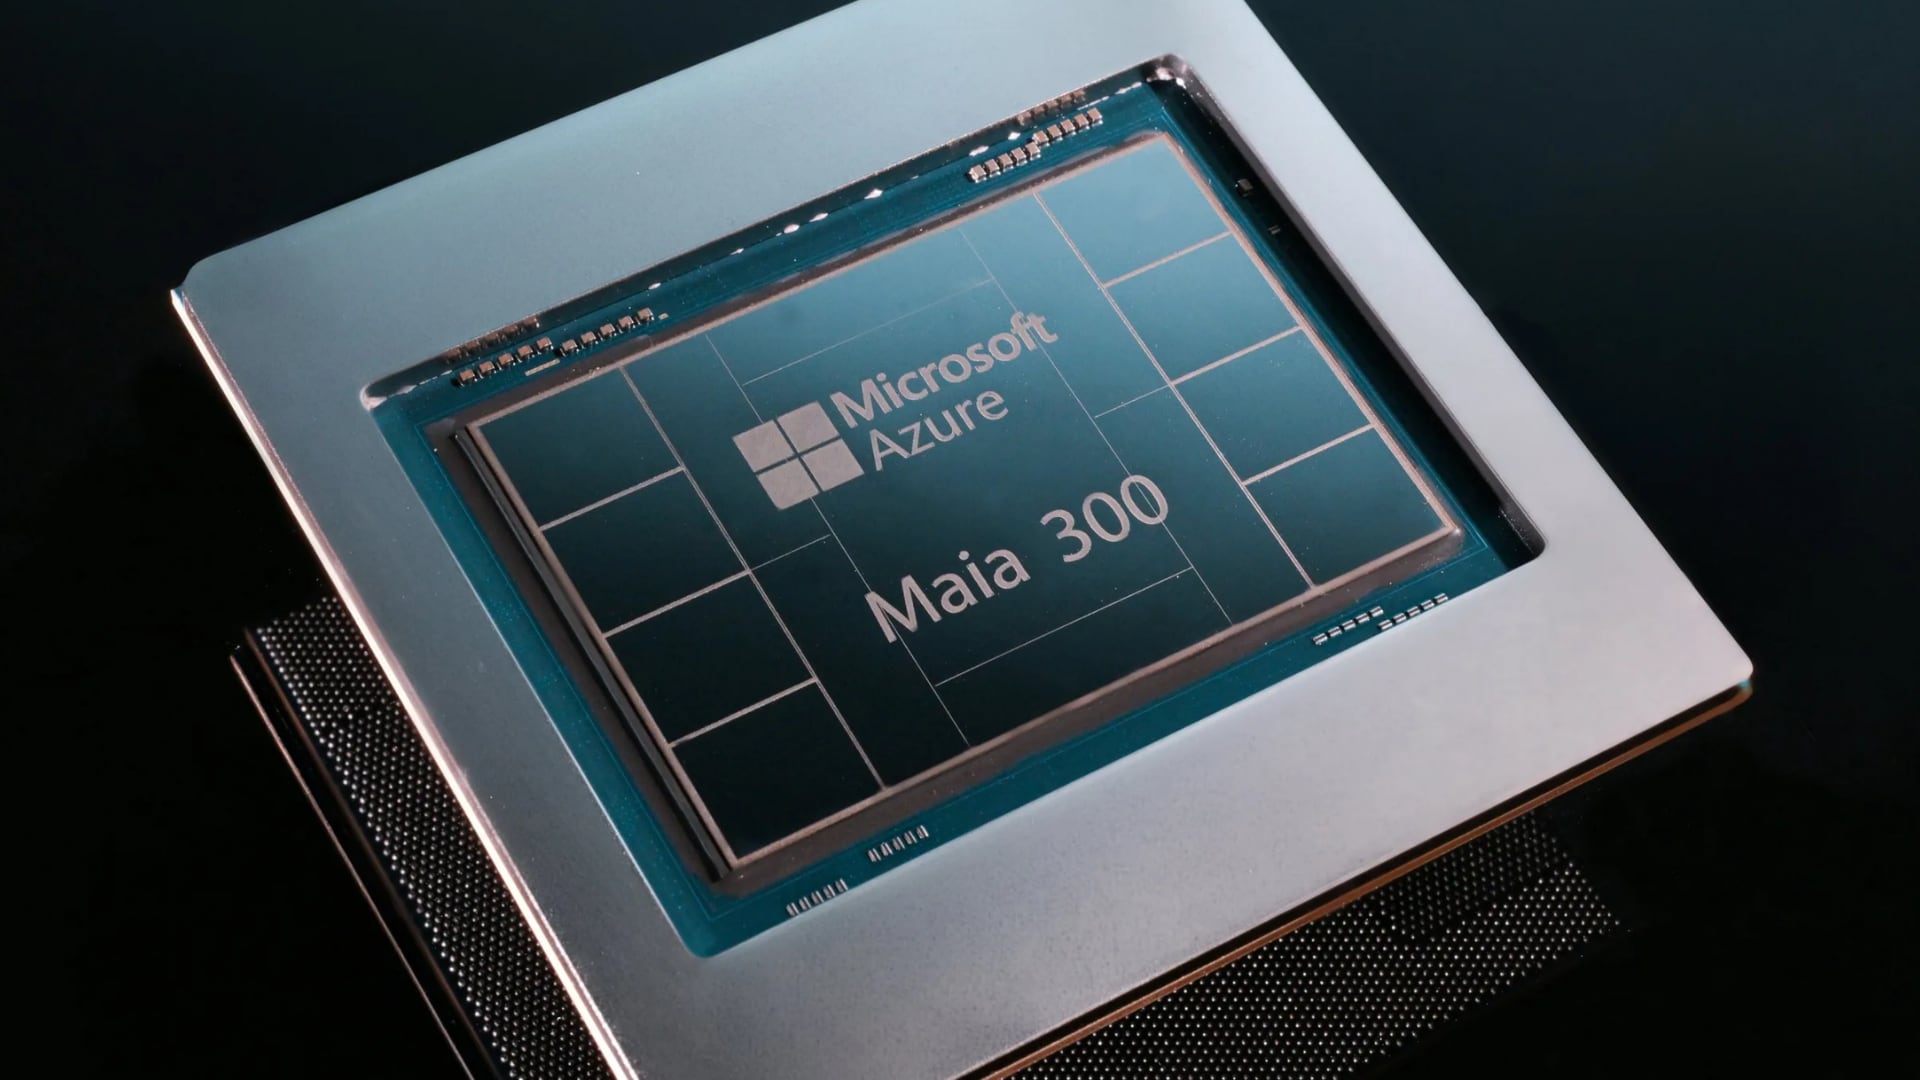
Microsoft presentó Maia 300, la tercera generación de sus aceleradores de inteligencia artificial, con un plan para desplegar el chip en producción a partir de 2027. La compañía busca así sumar potencia de procesamiento propia a sus centros de datos y reducir su dependencia de los procesadores de NVIDIA, uno de los principales proveedores de la industria de IA.
La apuesta no se limita a fabricar un componente más rápido. Microsoft quiere que Maia se convierta en su principal sistema de inferencia para productos y servicios de inteligencia artificial, con despliegues que alcancen una escala de varios gigavatios a partir del mismo año. Se trata de una hoja de ruta anunciada, todavía sin una transformación concluida de su infraestructura.
Qué significa que Maia 300 refuerce la inferencia de IA
Para dimensionar este anuncio conviene diferenciar dos procesos dentro del funcionamiento de la inteligencia artificial. El entrenamiento consiste en usar grandes volúmenes de datos para desarrollar las capacidades de un modelo. La inferencia, en cambio, ocurre cuando un usuario realiza una petición y el sistema debe generar una respuesta.
Microsoft orienta su nuevo acelerador hacia esa segunda tarea. El desarrollo no es inédito: la compañía presentó Maia 100 en 2023 y, en enero de 2026, lanzó Maia 200, que ya procesa cargas de trabajo reales, entre ellas las de Microsoft Copilot. Esa experiencia previa alimenta el diseño de la tercera generación.
Maia 300 se concibe como un sistema donde memoria, computación y comunicaciones operan de forma coordinada, no como un procesador aislado. Su arquitectura se basa en chiplets, componentes de silicio que distribuyen distintas funciones, con los bloques de cálculo fabricados mediante el proceso N2P de TSMC.
El chip incorpora además ocho pilas de memoria HBM4, tecnología que permite mover grandes volúmenes de datos a alta velocidad. Microsoft complementó ese diseño con un sistema de gestión del flujo de información mediante software, pensado para reducir desplazamientos innecesarios de datos y optimizar el uso de los recursos disponibles.
Rendimiento y consumo eléctrico: las cifras que maneja Microsoft
La compañía midió el salto de Maia 300 en dos variables: capacidad de procesamiento y eficiencia energética. Según sus propias estimaciones, el chip permitirá procesar un 40% más de tokens por megavatio que algunos de los principales sistemas basados en GPU, aunque Microsoft no identificó qué equipos utilizó como referencia de comparación.
Los tokens son las unidades en que los modelos de IA dividen el texto y otros contenidos para procesarlos, por lo que su rendimiento por unidad de energía resulta clave para calcular el costo real de operar estos sistemas a gran escala.
Microsoft también afirmó que un rack con 96 aceleradores ofrecerá hasta siete veces el rendimiento en tokens por rack de Maia 200, aunque esa configuración duplica además el número de aceleradores respecto a la generación anterior. Son comparaciones distintas entre sí, basadas en datos del propio fabricante y sin validación independiente publicada hasta el momento.
Infraestructura física: los límites de potencia que marcan la expansión
Llevar Maia 300 a una escala productiva exige algo más que diseñar el chip: requiere preparar los sistemas físicos que lo alojarán. Cada rack está diseñado para operar dentro de un límite de potencia de 167 kilovatios, un parámetro que permite coordinar el trabajo conjunto de múltiples aceleradores.
La hoja de ruta de Microsoft contempla iniciar en 2027 una expansión de la familia Maia hacia despliegues de varios gigavatios, aunque la compañía no anunció una fecha para alcanzar ese nivel de escala. Ese dato no es menor: la disponibilidad de electricidad y la capacidad física de las instalaciones son las variables que determinan hasta dónde pueden crecer estos servicios de inteligencia artificial.
La carrera por los chips propios entre los grandes clientes de NVIDIA
El movimiento de Microsoft se enmarca en una tendencia que ya tiene otros protagonistas. Google utiliza sus propias unidades TPU, mientras que Amazon ofrece servidores basados en Trainium, dos ejemplos de grandes clientes de NVIDIA que, en paralelo, desarrollan soluciones de silicio propias.
Esto no implica un distanciamiento total del fabricante estadounidense. Amazon y NVIDIA anunciaron en agosto un plan conjunto para desplegar dos millones de GPU adicionales en AWS entre 2027 y 2028, lo que confirma que la relación comercial entre ambas compañías continúa activa.
Lo que sí queda en evidencia es una estrategia compartida entre las grandes tecnológicas: empresas que necesitan volúmenes masivos de capacidad de procesamiento buscan desarrollar tecnología propia para cubrir parte de esa demanda y reducir su dependencia de proveedores externos como NVIDIA.