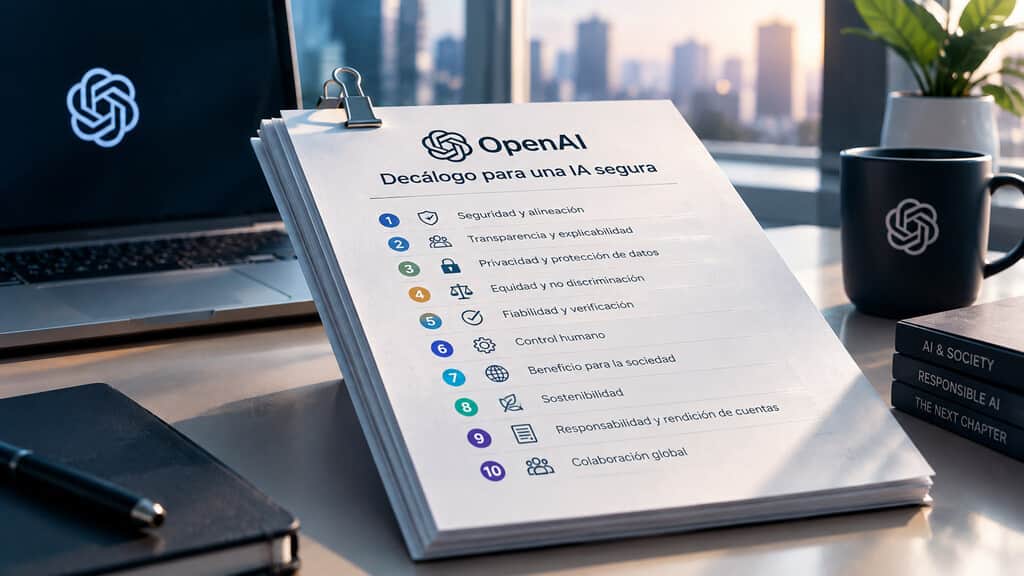
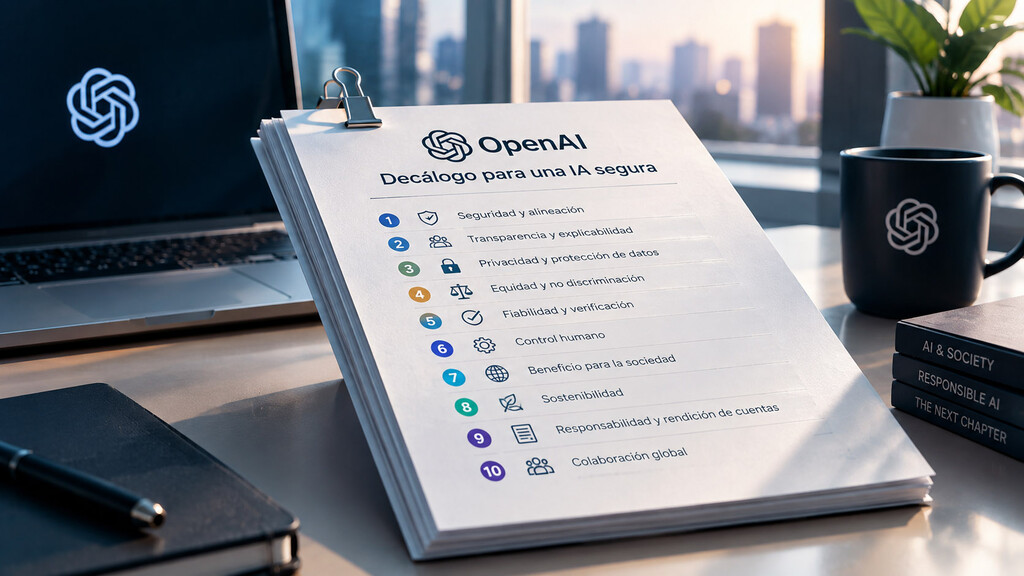
"Nuestro objetivo es garantizar que la inteligencia artificial (IA) general beneficie a toda la humanidad". Así empieza el artículo titulado "Desarrollar los estándares para la próxima fase de la IA" que publicó ayer mismo OpenAI. Sam Altman, el director general de este laboratorio, y Jakub Pachocki, su científico jefe, se han mostrado preocupados públicamente durante los últimos días por el desarrollo vertiginoso que está experimentando la IA. El artículo titulado "Una mente alienígena" que este último publicó el pasado 6 de septiembre no tiene desperdicio.
Sea como sea, algo está cambiando en los principales laboratorios de IA estadounidenses. Hasta hace apenas dos semanas se habían precipitado a una carrera desenfrenada por liderar el desarrollo de los modelos de frontera, y ahora estas mismas corporaciones quieren echar el freno. No obstante, hay algo más. Están empezando a proponer itinerarios que, en teoría, persiguen minimizar los riesgos asociados a la posible llegada de un modelo de IA lo suficientemente avanzado como para poder desarrollar por sí mismo modelos aún más sofisticados. Este concepto se conoce como mejora recursiva.
La solución a este escenario propuesta por OpenAI en el artículo que publicó ayer requiere establecer unos estándares técnicos comunes para los modelos de IA de frontera. De esta forma la seguridad, las evaluaciones y la gestión de los incidentes no dependerán únicamente de los laboratorios implicados y los países a los que pertenecen; habrá una supervisión presumiblemente neutral y superior que aprovechará el trabajo que ya están realizando los institutos de seguridad de la IA.
El auténtico desafío es proteger el control humano de los modelos de IA
El punto de partida de la estrategia que propone OpenAI consiste en encontrar la forma de que el desarrollo de los modelos de frontera esté acompañado por un desarrollo equiparable de la investigación en alineamiento. El propósito del alineamiento es garantizar que los modelos de IA más capaces y autónomos se comportan de acuerdo con los objetivos del ser humano y permanecen en todo momento bajo su supervisión. En este contexto la principal amenaza es, según los laboratorios estadounidenses que se han pronunciado, la automejora recursiva.